AI 量化交易工作流
最后更新:
固定数据、样本和评价指标,让模型生成因子代码,再用独立回测检验。
结论:从一条假设跑通一次独立实验
输入一条可计算假设、带时间戳的数据集和冻结的训练、验证、测试窗口。第一步先写明因子允许读取的字段与最晚可见时间,再让模型生成代码,交给隔离执行器和回测框架运行。
首轮成果是实验包:假设、代码、数据版本、基准、成本假设与完整指标。模型可以解释失败和提出下一轮修改,最终测试反馈由外部保留;KK API 只承担模型调用,Qlib 数据与执行环境另配。
| 实验字段 | 应在运行前固定 |
|---|---|
| 研究目标 | 因子定义、标签窗口与可用字段 |
| 数据切分 | 训练、验证和最终测试区间 |
| 评价口径 | 基准、回撤、换手、手续费与滑点 |
| 运行预算 | 最多迭代轮数、token 和代码执行时长 |
七个阶段缺一不可
量化交易的价值来自可复现流程,不来自某个模型的一次判断。七个阶段逐步缩小不确定性,并把研究权限与真实执行权限分开。
| 阶段 | 输入 | 输出 | 主要门禁 |
|---|---|---|---|
| 问题定义 | 研究目标与可用信息 | 可证伪假设 | 禁止用结果反推问题 |
| 数据准备 | 带时间戳的原始数据 | 版本化数据集 | 处理未来函数和幸存者偏差 |
| 因子实现 | 公式与字段 | 可运行代码 | 类型、缺失值与单位测试 |
| 训练验证 | 训练/验证区间 | 候选模型 | 调参不触碰最终测试集 |
| 回测 | 冻结规则 | 收益与风险指标 | 含滑点、手续费和容量 |
| 纸面交易 | 实时信号 | 模拟订单 | 记录延迟与不可成交情况 |
| 受限执行 | 审批后的策略 | 真实订单 | 仓位、限额、熔断和审计 |
RD-Agent 展示的是研究迭代,不是收益保证
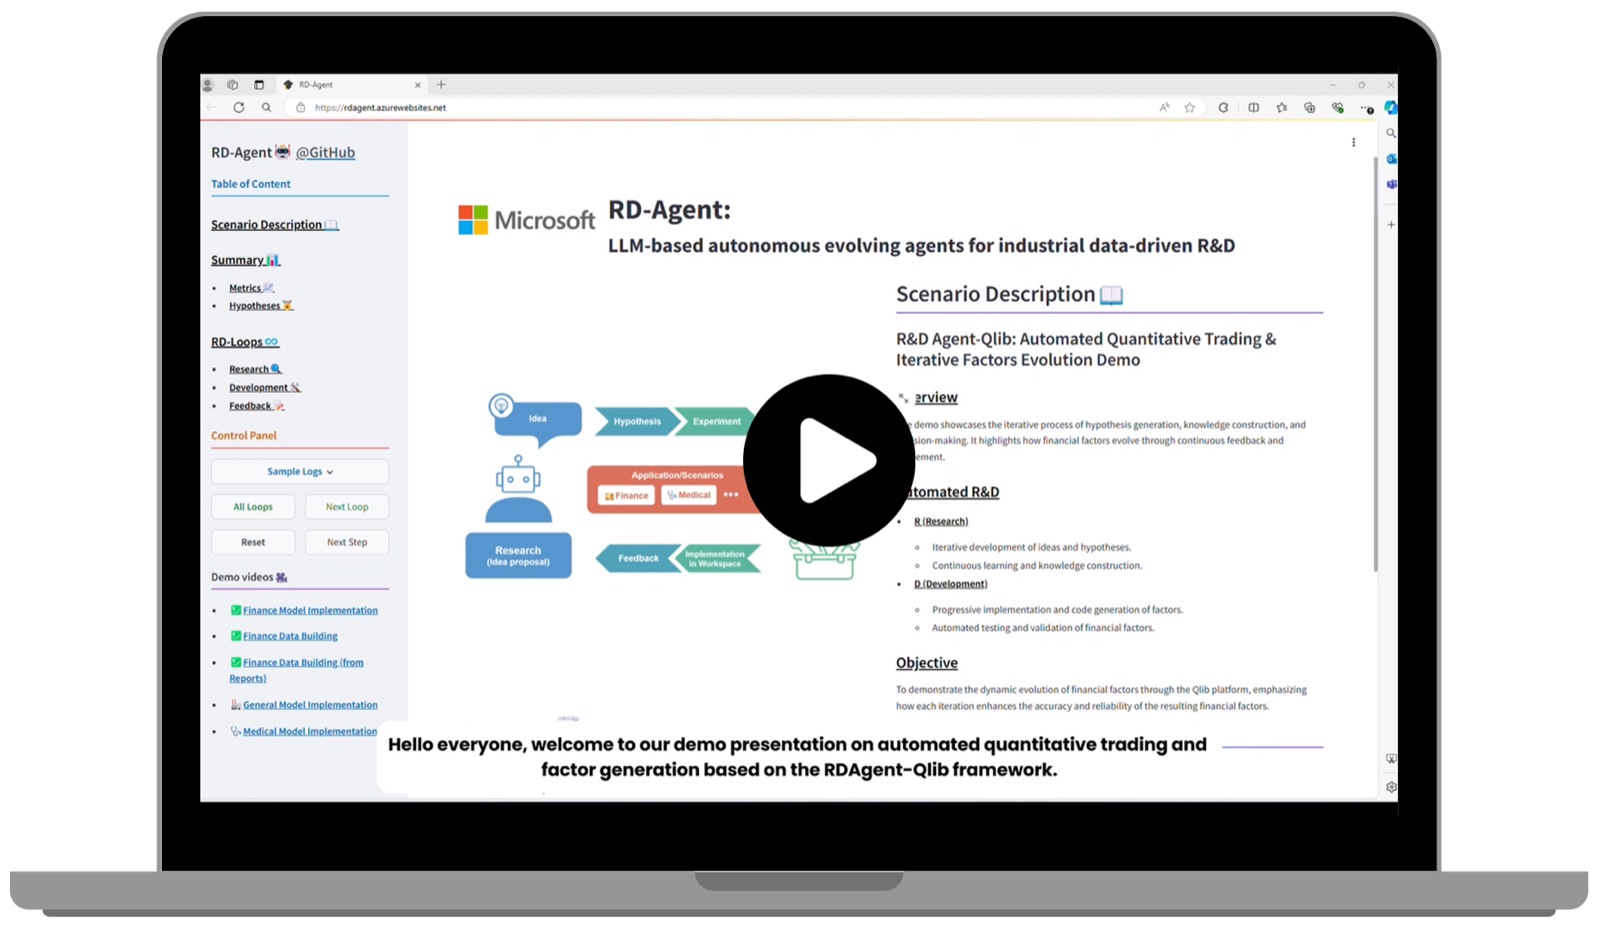
RD-Agent 试图自动完成假设、代码、实验与反馈循环,并可使用 Qlib 作为金融研发场景。官方演示有助于理解自动研究界面,但当前证据只确认源码配置入口,尚未完成项目自身真实模型调用,因此本文不把它写成已接通的生产系统。
模型入口和实验执行器必须分开
聊天模型负责提出修改和阅读日志,代码执行器负责在隔离环境运行;数据版本与指标定义由外部控制。即使模型服务切换,实验 ID、数据哈希和代码提交也应保持可追踪。
因子生成要先定义信息可用时间
一个“利润增长”因子不是拿利润字段除一下就结束。系统要知道报告期、公告日、修订日、交易日和当时是否可获得。新闻和研报也要区分事件发生时间与抓取时间。任何在决策时尚不可见的信息都不能进入特征。
Agent 生成代码后,自动测试应覆盖缺失值、停牌、复权、极端值、行业中性化与窗口边界。模型可以解释为什么要这样处理,但真正的验收来自确定性测试。
回测报告至少同时看收益和可交易性
高夏普或高累计收益不自动代表可交易。低频策略可能受财报时间处理影响,高频策略可能被延迟和滑点吞掉。模型应协助发现异常,而不是只为结果写解释。
- 相对基准收益、最大回撤、波动、换手和交易成本。
- 不同年份、牛熊阶段、行业和市值分组的稳定性。
- 信号产生时间、订单时间、成交规则和容量假设。
- 做过多少次试验,以及最终结果是否保留独立测试集。
成本控制从限制研究循环开始
一次任务成本 = 输入 token × 输入单价 + 输出 token × 输出单价 + 缓存读写费用 + 外部数据费用。模型价格和实际 token 只从当前模型目录与控制台调用日志读取,不在文章里复制一份会过时的数字。
自动研究会把一次问题扩展成多轮代码生成、运行、报错和总结。应设置每个假设的最大轮数、最大 token、最大执行时间和停止条件;把重复数据描述缓存,把完整日志保存在外部存储,只把当前需要的错误片段送回模型。
故障恢复必须以实验为单位
网络超时、依赖安装失败、代码运行超限和数据源缺失都应让当前实验进入明确失败态。重试必须复用 experiment_id,并区分“模型没有回复”和“代码运行失败”,分别记录每次模型用量,避免把两次结果拼成一次成功。
真正上线前,调度器还要支持暂停、取消、最大并发、资源配额和人工审批。执行层失败应默认不下单,不能让模型根据自然语言猜测是否继续。
实验配置的官方参考
Qlib workflow 文档 给出了 provider_uri、region、训练验证测试区间、基准和交易成本的配置位置。RD-Agent 锁定版本 用于核对自动研发入口。本文描述的是实验设计,项目入口审查发生于 2026 年 8 月,完整循环需要在你的环境单独验收。
常见问题
AI 量化交易需要会编程吗?
模型能帮助生成代码,但仍需要理解数据、回测和风险。不会验证代码的人更容易把能运行误认为正确。
RD-Agent 和 Qlib 是什么关系?
RD-Agent 面向自动研究循环,Qlib 提供金融数据、模型和实验底座。Qlib 本身不是通用聊天模型 Agent。
FinRL 能直接接大模型吗?
FinRL 主要是强化学习环境和算法,不是 OpenAI-compatible 聊天入口。大模型可以在上层帮助研究,但不能把两者写成同一种模型。
回测盈利为什么实盘会亏?
常见原因包括未来函数、过拟合、样本偏差、交易成本、容量、延迟和市场制度变化。纸面交易是发现这些差异的必要阶段。
自动研究怎么避免无限烧 token?
按实验设置轮数、token、时间和失败预算;缓存重复材料;将执行日志外置,只把必要片段交给模型。