AI 财报分析 Agent 怎么搭
最后更新:
从两期财报原文提取收入、现金流和风险,代码计算指标,模型生成带引用的解释。
用两期财报完成三项可追溯分析
先选一家公司、两个连续报告期,保存原始财报、公告发布日期和文件哈希。提取收入、经营现金流与重大风险,使用代码复算变化,再把带页码的证据卡交给模型解释。
输出应包含事实、计算公式、解释与引用,证据不足的项目保留为未知。先让这三项分析逐条回到原文,再扩展同业比较;模型 API 负责解释,财报文件和解析工具需要独立准备。
| 问题 | 先准备 | 复核重点 |
|---|---|---|
| 收入为什么变化 | 两期收入、分部信息与原文页码 | 期间、单位、合并范围一致 |
| 现金流质量如何 | 同期间利润与经营现金流 | 计算可复算,解释有引用 |
| 风险发生了什么变化 | 两期风险章节与更正公告 | 区分新增披露和已确认事件 |
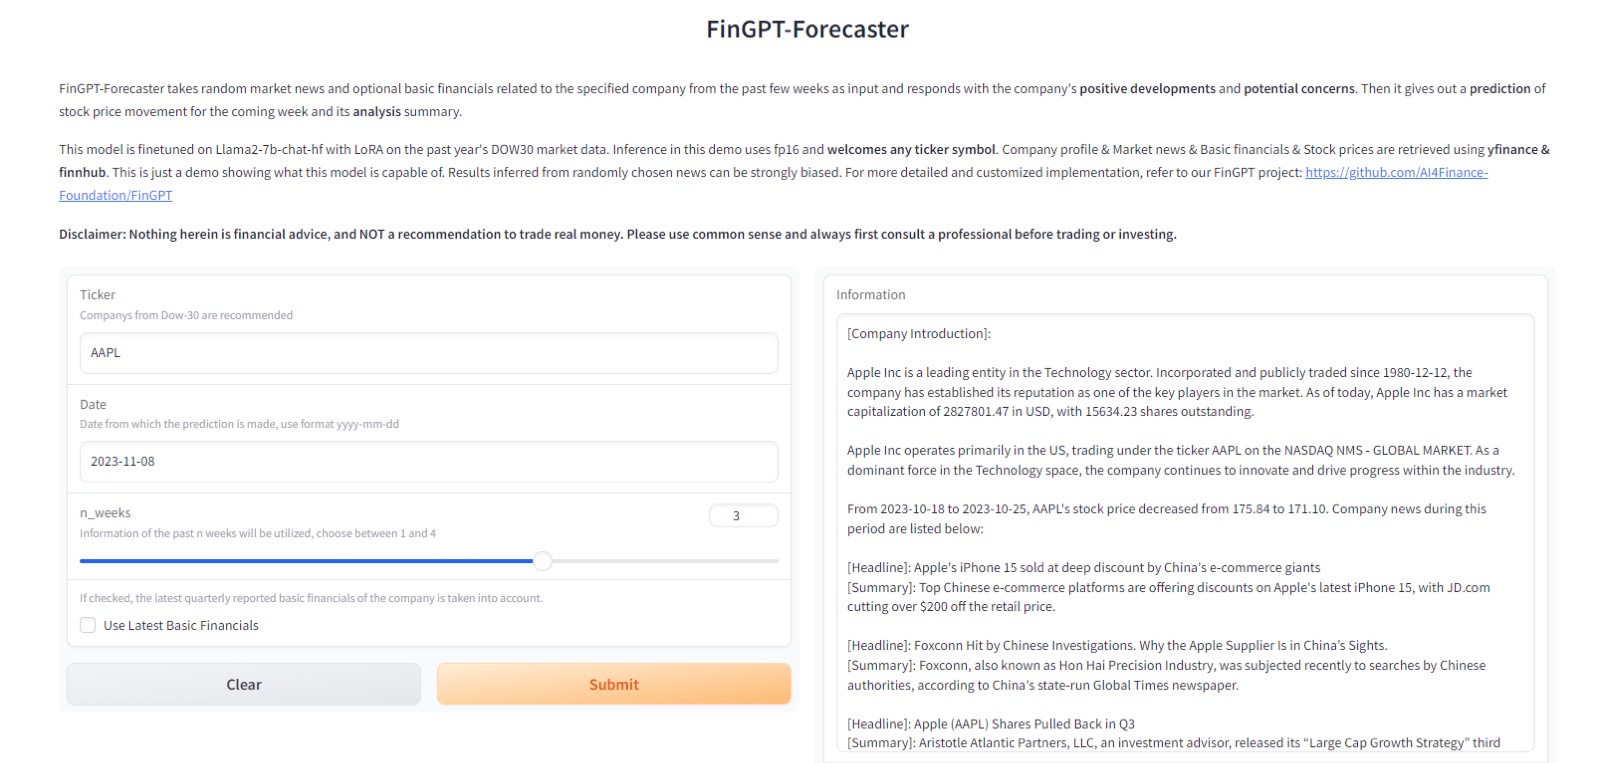
FinGPT 官方界面展示金融研究输入形态
这张官方截图说明金融研究工具通常需要标的与日期等明确输入。本文不把它当作本工作流已经运行的证据,而是用来说明:财报任务必须先锁定公司、报告期和当时可见资料。
完整数据流从文件版本开始
采集器保存原文件和响应头;解析器输出带页码或章节坐标的段落与表格;计算层生成指标;证据卡把数值、公式与原文绑定;模型只阅读证据卡并提出结论和反证。
证据卡使用稳定字段而不是长文本拼接
每张卡只表达一个可检查事实,包含来源、定位、单位、期间、计算和状态。模型收到的是证据卡数组,不是无法定位的 PDF 大段文本。
from dataclasses import asdict, dataclass

@dataclass
class EvidenceCard:
    claim_id: str
    metric: str
    value: float
    unit: str
    period: str
    source_url: str
    source_locator: str
    published_at: str
    formula: str | None = None

card = EvidenceCard(
    claim_id="revenue-current",
    metric="revenue",
    value=123.4,
    unit="CNY million",
    period="2026-H1",
    source_url="https://issuer.example/report.pdf",
    source_locator="page 18, table 4",
    published_at="2026-08-01T08:00:00+08:00",
)
payload = asdict(card)
模型只基于卡片回答并返回引用 ID
示例要求 JSON 中每条判断携带 claim_ids,程序先检查引用 ID 是否存在,再人工或另一个复核步骤核对引用是否支持判断。JSON 解析失败或引用缺失都应让该次分析进入待复核状态;ID 存在本身不证明句子正确。
import json, os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["KKAIAPI_KEY"],
    base_url="https://api.kkaiapi.com/v1",
)
response = client.chat.completions.create(
    model=os.environ.get("KKAIAPI_MODEL", "gpt-6.1-sol"),
    temperature=0,
    messages=[
        {"role": "system", "content": "只使用证据卡,返回 JSON:judgments 数组中每项含 text 与 claim_ids;未知项放 unknowns。"},
        {"role": "user", "content": json.dumps([payload], ensure_ascii=False)},
    ],
)
answer = response.choices[0].message.content or ""
parsed = json.loads(answer)
known_ids = {payload["claim_id"]}
assert isinstance(parsed.get("judgments"), list)
for item in parsed["judgments"]:
    citations = item.get("claim_ids", [])
    assert citations and set(citations) <= known_ids
# 引用 ID 存在后,仍要核对原文是否真正支持该条判断。
每个阶段都有明确通过条件
财报分析不是一次模型请求,而是一条证据生产链。阶段门禁能把下载、解析、计算和引用错误定位到具体步骤,同时保留可恢复的中间结果。
| 阶段 | 输入 | 通过条件 | 失败时保留 |
|---|---|---|---|
| 采集 | 公司、报告期 | 原文件哈希与发布日期可复现 | HTTP 状态与原始响应 |
| 解析 | PDF / HTML | 关键表格与章节有定位 | 失败页码与解析日志 |
| 计算 | 结构化字段 | 单位、期间、公式明确 | 缺失字段与异常值 |
| 模型复核 | 证据卡 | 每条判断引用存在 | 请求 ID、原始错误与重试 |
| 发布 | 带引用草稿 | 链接可打开且数字一致 | 未闭环条目 |
防止未来信息和口径错配
纳入分析的财报发布日期必须早于或等于研究截止日,不能按报告期末误判信息已经公开。同比计算要确认币种、单位、合并范围、会计准则和重述情况;现金流与利润的比较要使用相同期间。
若公司后来发布更正公告,应作为新版本加入,而不是覆盖旧文件。历史复跑使用当时可见版本,当前研究则明确采用最新修订。
成本、失败和可恢复重试
一次任务成本 = 输入 token × 输入单价 + 输出 token × 输出单价 + 缓存读写费用 + 外部数据费用。模型价格和实际 token 只从当前模型目录与控制台调用日志读取,不在文章里复制一份会过时的数字。
财报任务的主要浪费来自重复发送长原文。先在本地解析并压缩为证据卡,按章节缓存,再让模型阅读。下载失败可重试采集;解析失败只重跑对应页;模型 429 按服务端节奏退避;引用检查失败退回模型重写。每次重试沿用同一 job_id,并记录尝试编号。
| 故障 | 是否可重试 | 恢复点 |
|---|---|---|
| 原文件暂时不可用 | 是 | 采集阶段 |
| 表格结构无法解析 | 人工确认后 | 单页或单表 |
| 模型超时 / 429 | 是 | 同一证据卡请求 |
| 引用不存在 | 是 | 模型复核阶段 |
| 原始数据矛盾 | 不可自动决定 | 人工审查 |
原始文件和模型管线的参考入口
美股财报原文可从 SEC EDGAR 官方入口 获取,访问时遵守其请求规范。本文 EvidenceCard 的数值和 issuer.example 地址均为结构示例,不是公司事实。金融模型与应用管线的区别见 FinGPT 官方仓库。
常见问题
为什么不直接把整份 PDF 发给模型?
整份 PDF 容易出现表格错位、定位困难和重复 token。先解析为带来源的证据卡,更容易验证和重试。
模型能负责同比和比率计算吗?
可以复核解释,但关键计算应由确定性代码完成,并把公式、单位和期间写入证据卡。
怎样防止使用未来信息?
保存文件发布日期与研究截止日,历史复跑只加载截止日前真实可见的文件版本。
引用检查通过就代表结论正确吗?
不代表。它证明结论有来源,还需要核对计算口径、数据完整性和模型推理。
财报 Agent 最先应该做哪三个问题?
收入变化、经营现金流质量和重大风险,范围足够窄,便于逐条核对原文。