AI 选股工具怎么选
最后更新:
规则筛选、候选研究和因子回测各有用途,先确定输出,再选择工具与模型。
结论:先确定要股票池、报告还是回测
要按估值、增长或流动性缩小范围,用可复算的规则筛选;要解释候选公司,用能返回来源的研究 Agent;要检验规则是否有效,用固定历史数据的回测框架。三种工具可以串联,各自验收输出。
第一步写出股票池、截止日、筛选条件和预期交付物,再选一个历史日期试跑。模型负责候选复核,金融数据由独立来源提供;接入 KK API 不会自动获得证券行情。
| 需要的结果 | 首轮必须能导出 |
|---|---|
| 候选股票池 | 规则、字段值、截止日和淘汰原因 |
| 候选研究报告 | 支持证据、反证、引用和未知项 |
| 策略检验 | 数据版本、交易假设、基准与样本外指标 |
四类工具解决的问题不同
选股工具可以输出规则股票池、研究报告、可计算因子或综合工作台,但这些输出不能互相替代。先确认需要哪一种结果,再评估数据和验证成本。
| 类型 | 主要输出 | 代表项目 | 适合场景 | 主要风险 |
|---|---|---|---|---|
| 规则筛选 | 满足条件的股票池 | 自建脚本、数据平台 | 估值/增长/流动性初筛 | 字段口径与时点错误 |
| 研究 Agent | 带来源的候选股报告 | TradingAgents-CN、daily_stock_analysis | 阅读公告和多角度复核 | 幻觉与证据缺失 |
| 量化研发 | 因子、代码和回测 | RD-Agent + Qlib | 验证可计算策略 | 过拟合与未来函数 |
| 综合工作台 | 数据、研究、回测界面 | Vibe-Trading、QuantDinger | 团队化研究流程 | 部署复杂与权限过大 |
中文报告界面不等于 A 股数据已经完整
TradingAgents-CN 提供中文研究报告和多市场定位,适合观察中文用户流程。当前锁定版本只完成源码入口审查,没有项目自身真实调用;且根目录与 app/frontend 使用不同许可证。文章使用的是根目录 Apache-2.0 截图,不复制专有界面代码。
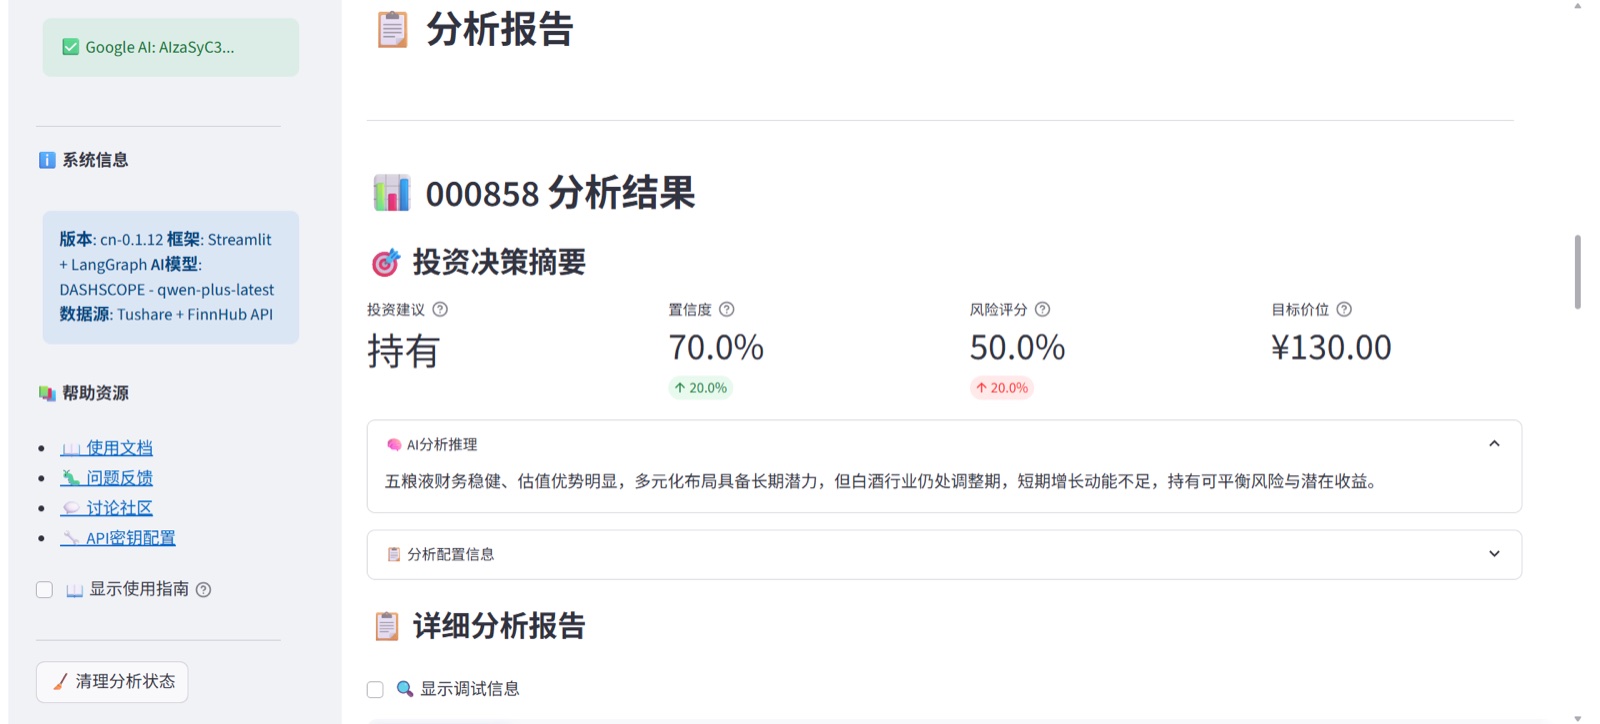
一个合理选股链先筛选再复核
结构化过滤器先根据交易日可见数据生成候选池;模型读取每个候选的证据卡和风险项;回测模块检验筛选规则;人类决定是否进入观察列表。
A 股工具必须回答的数据问题
这些问题决定回测是否可信,模型中文能力无法补偿错误数据。若工具不披露数据时点,只适合做当前信息整理,不适合声称历史验证。
- 是否保存历史成分股、退市股和证券代码变更。
- 财报按报告期还是公告日进入策略,修订如何处理。
- 前复权、后复权、停牌、涨跌停和不可成交如何定义。
- 北向、龙虎榜、公告和新闻的更新时间与授权范围。
开源许可证影响你能怎样使用项目
先读取采用版本的根目录和目标子目录许可证,并根据修改、分发或托管方式检查义务;保留需要的署名与许可文件。未声明许可证的仓库不能默认获得复制和分发授权。
因此项目地图会同时展示许可证和证据状态。台账中未声明许可证的 FINCON、StockAgent 作为项目观察线索,实际使用前应核对授权;go-stock 和 OpenBB 只做客观介绍,不在本站托管其实现。
模型与数据成本要分别记账
一次任务成本 = 输入 token × 输入单价 + 输出 token × 输出单价 + 缓存读写费用 + 外部数据费用。模型价格和实际 token 只从当前模型目录与控制台调用日志读取,不在文章里复制一份会过时的数字。
选股任务的总成本还取决于候选数量。先用 SQL 或规则筛掉绝大部分股票,再把少量证据卡交给模型,通常比让 Agent 逐股自由研究更可控。模型实际价格从当前目录读取,数据源费用单独纳入预算。
购买或部署前做一轮可复现验收
选择一个历史日期和固定股票池,保存输入数据;要求工具输出候选、淘汰原因、引用与错误;人工抽查关键数字;再在独立区间复跑。若结果无法导出、无法解释时点或换模型后规则随文字变化,这个工具更适合辅助阅读,不适合作为选股系统。
按官方配置核对工具能力
每日报告渠道参考 daily_stock_analysis .env.example,回测框架参考 Qlib workflow。本文引用的项目审查状态属于 2026 年 8 月台账;许可证应按你实际采用的 commit 和使用目录重新核对。
常见问题
AI 选股软件哪个最好?
没有脱离任务的最好。规则筛选、研究报告和量化回测需要不同工具,先确定输出与验收标准再选择。
A 股选股为什么要特别处理?
公告时点、复权、停牌、涨跌停、历史成分股和退市样本都会改变结果,不能直接套用美股示例。
中文界面项目就一定适合 A 股吗?
不一定。界面语言与数据完整性是两件事,仍需检查行情、公告、财务数据的来源和历史规则。
可以让模型逐只分析全市场吗?
技术上可以,但成本和错误面很大。更合理的是确定性初筛后只分析候选股。
开源项目能直接商业使用吗?
取决于许可证。MIT/Apache、GPL/AGPL 和未声明许可证的义务不同,需要按锁定版本逐项确认。